
從資訊安全與隱私保護角度來看,另一個重要且更容易被忽略的問題:孩子把什麼資料告訴了AI?當孩子請AI協助寫作文、製作PPT或解決問題時,可能順手輸入姓名、學校、班級、住址、電話,甚至上傳自己或家人的照片、家庭成員資訊,如果為了詢問帳號問題,又把帳號、密碼或驗證碼一起貼上風險又更高了,這個觀念其實可以與之前小弟參與的鐵人賽主題「規劃產品服務設計隱私建立安全數位生活」系列相呼應,從個資保護架構探討「蒐集什麼資料、如何蒐集、如何使用、使用目的、保存多久以及如何處理資料」等問題,核心精神在資料餵給系統之前,就必須先思考資料是否真的需要被蒐集,在AI時代這個概念可以簡化成孩子容易理解的一句話:「AI需要知道多少,才能完成這件事?」如果只是修改一篇作文,通常不需要提供真實姓名、學校與住址;如果只是詢問數學題,更不需要提供家庭資料。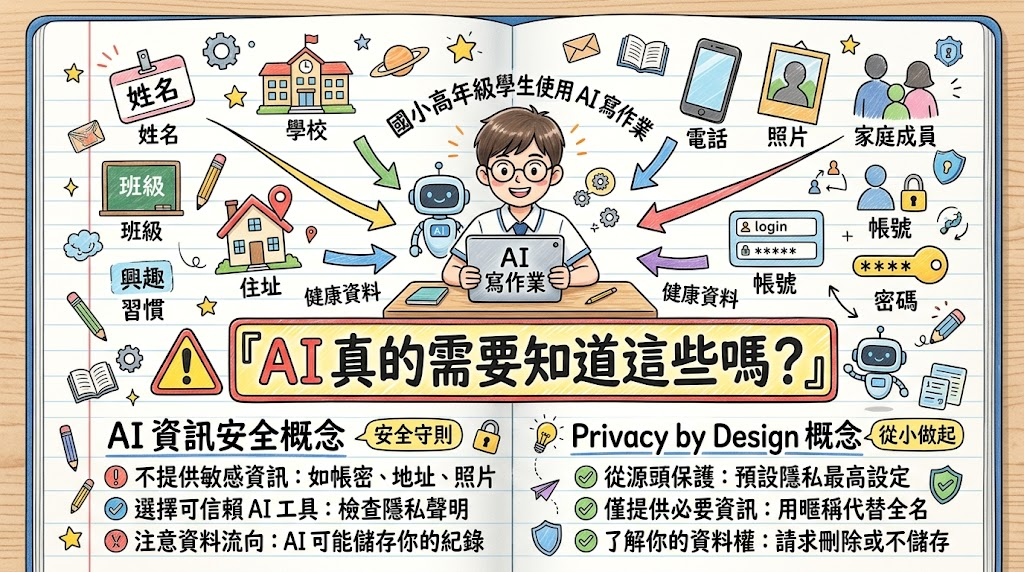
對孩子而言,保護個資隱私這議題,如果一直耳提面命只說網路很危險,這通常太抽象孩子根本無法理解,因此可以規劃設計一個簡單的AI資料分類分級來做解釋。
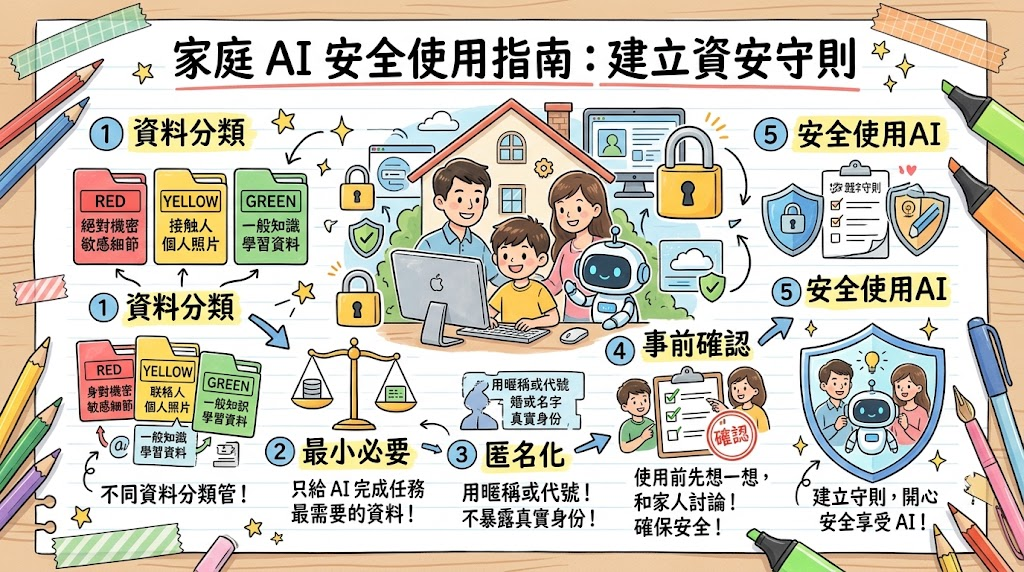
2021年在鐵人賽「規劃隱私資料敏感度分級」提出一個重要觀念:不是所有資料都需要用相同程度保護,而應該先盤點資料,再依照敏感性與可能造成的影響程度進行分級;敏感度越高,就需要越嚴格的控管。原文將資料敏感度規劃為四級,一級到四級代表敏感程度逐步提高,讓資料管理可以依風險採取不同的處理方式。到了生成式AI時代,這個企業資料治理概念適合轉換成家庭版的「AI資料敏感度分級,為了讓國小學生容易理解,可以簡化成三種顏色:
A類:一般資料:低敏感度
例如公開的課本內容、一般知識問題、自己創作且不包含個人資料的文章、公開新聞或已經公開的資訊。這類資料即使提供給AI,對個人造成的影響通常較低,但仍應養成只提供完成任務所需要的資料習慣。
B類:謹慎資料:中敏感度
例如姓名、學校名稱、班級、照片、家庭成員、學習紀錄、活動地點、聯絡資訊等,單獨看可能不一定高度敏感,但如果把多項資料組合起來,就可能逐漸拼出一個孩子的身分、生活範圍與活動軌跡,因此提供給AI前,應先經過家長或老師確認,必要時採取匿名化,例如把「六年一班林小明」改成「六年級學生A」。
C類:高度敏感資料:高敏感度
例如身分證件、密碼、驗證碼、帳號金鑰、信用卡資料、金融資訊、健康資料,以及其他人的個人資料或未公開機密。這類資料的重點不是「提供前先想一下」,而是原則上不要直接提供給一般AI工具。如果資料外洩可能造成重大影響,就應採取更高強度的保護措施。
這樣的資料分級,實際上就是把資訊安全裡的「敏感度分級」轉化成孩子每天都能使用的判斷工具,資料分級不能只看資料名稱,也要看外洩後可能造成什麼影響,同一個資料在不同情境下,敏感程度可能不同,因此可以逐步教孩子理解「資料本身」與「資料組合後的風險」。這也延續了隱私規劃的核心精神:先盤點資料、判斷敏感度,再決定適當的保護方式。
資料安全教育真正的目標,不是讓孩子害怕AI,而是建立一套在使用AI之前就會自然啟動的判斷流程。家庭可以建立一條非常簡單的規則:「不確定能不能告訴AI,就先問爸媽或老師。」再進一步加入三個檢查問題:「這是誰的資料?AI真的需要嗎?如果資料公開會不會造成問題?」例如製作學校PPT作業時使用匿名化的同學資料;製作家庭成員介紹作業時,可以使用爸爸、媽媽、哥哥等稱呼取代真實姓名;請AI修改文件時,只提供完成任務所需要的最少內容。資料安全不是等資料外洩後才處理,而是在資料蒐集、使用與保存之前,就先做好規劃。相關系列曾將資訊安全、內部控管與個人資料處理放在同一個隱私保護架構中思考。 進入生成式AI時代後,可以再增加一個重要觀念:不只檢查「AI回答了什麼」,也要檢查「AI拿到了什麼」。當孩子逐漸養成資料分類、最小必要、匿名化與事前確認的習慣,AI素養就不再只是「會使用AI」,而是同時具備資訊安全與隱私保護能力。這也讓去年鐵人賽的邪惡隱形斗篷下的智慧生活點點點的安全數位生活的知識,可以自然延伸成今天的安全AI生活,科技可以放心使用,但資料必須有界線。


 iThome鐵人賽
 看影片追技術